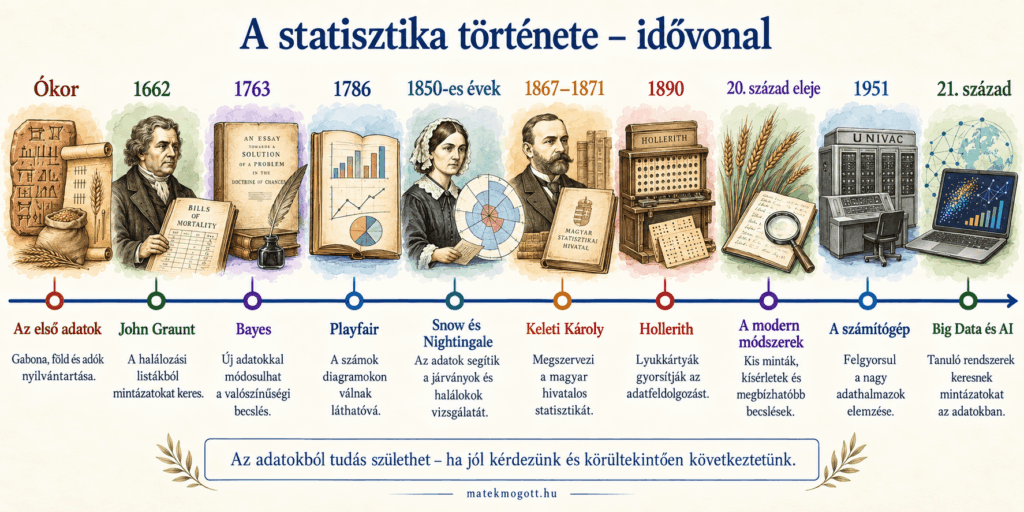
A statisztika története – amikor a számok mesélni kezdenek
A statisztika ma szinte mindenütt jelen van körülöttünk. Találkozunk vele a hírekben, a sporteredményekben, az időjárás-előrejelzésben, a közvélemény-kutatásokban, az orvosi vizsgálatokban, sőt még akkor is, amikor egy internetes oldal filmet, zenét vagy terméket ajánl nekünk.
De a statisztika nem átlagokkal és diagramokkal kezdődött. Története sokkal régebbre nyúlik vissza: akkor kezdődött, amikor az emberek először próbálták megszámolni és nyilvántartani a körülöttük lévő világot.
Valójában a statisztika története arról szól, hogyan tanultuk meg az adatok segítségével megérteni a múltat, eligazodni a jelenben és következtetni a jövőre.
🏺Ókor
𓂀 Ókori Egyiptom – a számok, mint az állam emlékezete
Az ókori Egyiptom hatalmas államszervezete nem működhetett volna pontos nyilvántartások nélkül. Tudni kellett, mennyi gabona érkezett a raktárakba, mekkora földterületet művelnek, mennyi adót kell beszedni, és hány munkásra van szükség az építkezésekhez.
Az írnokok ezért rendszeresen feljegyezték a termést, a szállításokat, a földbirtokokat és az adókat. Nem azért gyűjtöttek adatokat, mert statisztikai elemzést akartak készíteni, hanem azért, mert az államnak döntenie kellett.
Lesz-e elegendő élelem a következő aratásig? Mennyit lehet kiosztani? Mekkora adót lehet beszedni?
Ezek a feljegyzések még nem jelentettek modern statisztikát, de már megjelent bennük annak egyik legfontosabb alapgondolata: amit nem tudunk fejben tartani, azt rendszeresen rögzíteni és rendezni kell.
𒀭Mezopotámia – amikor az írás egyik első feladata a könyvelés lett
A Tigris és az Eufrátesz vidékén kialakult városok templomai és palotái hatalmas készleteket kezeltek. Gabonát, kenyeret, olajat, sört és állatokat tartottak nyilván, ezért pontosan tudni kellett, mi érkezett be, mit osztottak ki, kinek és mikor.
A legkorábbi mezopotámiai agyagtáblák jelentős része gazdasági feljegyzéseket tartalmaz. A táblákon számjelek, egyszerű képek és különböző kategóriák segítségével rögzítették a mennyiségeket.
Ezek a táblák meglepően hasonlítanak egy mai adattáblázat alapgondolatához: szerepel rajtuk az esemény, a mennyiség, az időpont és sok esetben az érintett személy vagy csoport is.
Az adatgyűjtés célja itt is gyakorlati volt: átláthatóvá és ellenőrizhetővé kellett tenni a gazdaság működését.
🏛️ Az ókori görögök – amikor az adatokat összehasonlítani kezdték
Az ókori görögök nemcsak nyilvántartásokat készítettek, hanem megfigyeléseiket egyre gyakrabban össze is hasonlították.
Arisztotelész és iskolája számos görög városállam politikai berendezkedéséről gyűjtött adatokat és leírásokat. A különböző államformák, törvények és intézmények összevetésével általánosabb következtetéseket próbáltak megfogalmazni.
Itt jelenik meg egy fontos szemléletváltás: az adat már nemcsak arra szolgál, hogy megőrizzünk valamilyen információt, hanem arra is, hogy különböző eseteket összehasonlítsunk, hasonlóságokat és eltéréseket keressünk.
Ez még mindig nem statisztika a mai értelemben, de már közelebb kerültünk a statisztikai gondolkodáshoz.
🏟️A rómaiak – a census és az állami döntések
A Római Birodalomban különösen fontossá vált a polgárok, a vagyon és a földbirtokok rendszeres számbavétele.
A római census során feljegyezték a polgárjoggal rendelkező személyeket és vagyoni helyzetüket. Ezek az adatok hatással voltak az adózásra, a katonai szolgálatra és a társadalmi besorolásra is.
A census tehát nem egyszerű névjegyzék volt. Az összegyűjtött adatok alapján az állam döntéseket hozott.
A római példában már világosan felismerhető a statisztika egyik legfontosabb szerepe: az adatok segítik a tervezést és a kormányzást.
A census szó öröksége ma is él. Számos nyelvben ebből a kifejezésből származik a népszámlálás elnevezése.
🏰 A középkor – föld, vagyon és adó a nagy összeírásokban
A Nyugatrómai Birodalom bukása után az adatgyűjtés Európában sok helyen töredezettebbé vált, de nem tűnt el. A királyi, földesúri és egyházi intézmények továbbra is vezettek birtok-, jövedelem- és adónyilvántartásokat.
Az egyik leghíresebb középkori összeírás az 1086-ban elkészült angliai Domesday Book.
A nagyszabású felmérésben rögzítették, ki birtokolta a földeket, hogyan használták őket, mennyit értek, és milyen gazdasági erőforrások tartoztak hozzájuk.
A Domesday Bookot néha középkori népszámlálásnak nevezik, de valójában elsősorban föld- és vagyonösszeírás volt. Az uralkodó arra volt kíváncsi, milyen javakkal rendelkezik az ország, és mekkora adóbevételre számíthat.
🔭 Újkor
John Graunt – amikor a halálozási listák „beszélni” kezdtek
A statisztika történetének egyik legfontosabb fordulata a 17. századi Londonban következett be.
A városban rendszeresen közzétették a halálozási jegyzékeket, amelyekben feljegyezték a halálesetek számát és feltételezett okát. Ezeket a listákat elsősorban azért készítették, hogy figyelemmel kísérjék a járványokat.
John Graunt azonban 1662-ben valami újat tett: nemcsak elolvasta, hanem elemezni kezdte a jegyzékeket.
Összehasonlította az egyes évek adatait, megvizsgálta a halálozási okokat, következtetett London lakosságának nagyságára, és szabályszerűségeket keresett az adatokban.
Ezzel a puszta adatgyűjtésből lassan következtető tudomány született.
Pascal, Fermat és Halley – a bizonytalanság matematikája
A 17. században egy szerencsejátékkal kapcsolatos kérdés új matematikai terület kialakulásához vezetett.
Pascal és Fermat azt vizsgálta, hogyan lehet igazságosan felosztani a nyereményt, ha egy játékot idő előtt félbeszakítanak. A megoldáshoz meg kellett határozniuk, mekkora esélye lett volna az egyes játékosoknak a győzelemre.
Ezekből a gondolatokból bontakozott ki a valószínűségszámítás, amely később a statisztika egyik matematikai alapjává vált.
Edmond Halley csillagász halálozási adatokból élettáblát készített. Megmutatta, hogy az adatok segítségével megbecsülhető, egy adott életkorú ember átlagosan még hány évig élhet.
Ez az eredmény fontos szerepet játszott az életbiztosítások és a biztosítási matematika fejlődésében.
Gauss és a mérési hibák – hol rejtőzik az „igazi” érték?
Ha ugyanazt a hosszúságot többször megmérjük, valószínűleg kissé eltérő eredményeket kapunk. De melyik mérés mutatja a valódi értéket?
Ez a kérdés különösen fontos volt a csillagászok és földmérők számára. A mérési hibák vizsgálata során derült ki, hogy sok eltérés jellegzetes, harang alakú eloszlást követ.
Ez lett a normális eloszlás, amelyet gyakran Gauss-görbének vagy haranggörbének is nevezünk.
Legendre és Gauss munkája nyomán kialakult a legkisebb négyzetek módszere is. Ennek segítségével több, kissé eltérő mérésből meghatározható az az érték vagy pálya, amely a lehető legjobban illeszkedik a megfigyelésekhez.
A 19–20. század – megszületik a modern statisztika
A 19. században a statisztikai módszereket egyre gyakrabban alkalmazták társadalmi és természettudományos kérdések vizsgálatára.
Adolphe Quetelet megalkotta az „átlagember” fogalmát, és azt kutatta, milyen szabályszerűségek jelennek meg nagy embercsoportok adataiban.
Francis Galton a percentilisek, a korreláció és az átlaghoz való visszatérés gondolatát vizsgálta. Karl Pearson továbbfejlesztette a korreláció matematikai leírását, és jelentős szerepet játszott abban, hogy a statisztika önálló tudományos területté váljon. Pearson a biometria, vagyis a biológiai adatok statisztikai elemzésének egyik megalapozója volt.
A történetükhöz azonban sötét tanulság is kapcsolódik: Galton és Pearson az eugenika (emberfaj-nemesítés) hívei voltak. Ez arra figyelmeztet, hogy a statisztikai módszerek nemcsak hasznos, hanem káros célokra is felhasználhatók.
A 20. század elején William Sealy Gosset a Guinness sörgyárban dolgozva a kis minták elemzésére keresett módszert. Eredményeit „Student” álnéven publikálta, ezért ma is Student-féle t-eloszlásról és t-próbáról beszélünk.
Ronald Fisher a statisztikai kísérlettervezés és a hipotézisvizsgálat fejlődéséhez járult hozzá. Neyman és Egon Pearson pedig azt vizsgálta, hogyan lehet bizonytalan adatok alapján úgy dönteni, hogy közben a tévedés kockázatát is figyelembe vesszük.
Amikor az adatok láthatóvá váltak
A statisztika fejlődésében nemcsak az számított, hogyan gyűjtjük és elemezzük az adatokat, hanem az is, hogyan mutatjuk meg őket.
William Playfair a 18. század végén oszlop- és vonaldiagramokkal ábrázolta a gazdasági adatokat.
John Snow 1854-ben egy londoni térképen jelölte a kolerás haláleseteket. A pontok sűrűsödése egy fertőzött vízforrás felé mutatott, és segített feltárni a járvány terjedésének okát.
Florence Nightingale diagramok segítségével mutatta meg, hogy a katonák közül sokkal többen haltak meg fertőzések és rossz higiéniai körülmények miatt, mint a harctéri sérülések következtében.
A grafikon ettől kezdve már nem egyszerű dísz volt. Bizonyítékká, magyarázattá és érvelési eszközzé vált.
Hogyan tudhatunk valamit anélkül, hogy mindent megszámolnánk?
Nem lehet mindig minden embert, terméket vagy állatot megvizsgálni. Ezért a statisztika egyik legfontosabb kérdése az lett, hogyan válasszunk olyan mintát, amely megfelelően képviseli az egész sokaságot.
Egy jól kiválasztott kisebb minta sokszor megbízhatóbb eredményt ad, mint egy hatalmas, de torz adathalmaz.
Ezt mutatta meg az 1936-os amerikai elnökválasztás híres esete is. A Literary Digest több mint kétmillió választ gyűjtött össze, mégis rossz győztest jósolt. A probléma nem a minta nagysága, hanem a kiválasztás módja volt: a válaszadók nem képviselték megfelelően a teljes választói népességet.
A statisztikában tehát nemcsak az számít, hány adatunk van, hanem az is, honnan származnak.
Napjainkban – Big Data és mesterséges intelligencia
A 19. század végén Herman Hollerith lyukkártyás gépe jelentősen felgyorsította az amerikai népszámlálási adatok feldolgozását. A 20. században a számítógépek még nagyobb változást hoztak: olyan mennyiségű adat elemzését tették lehetővé, amelyet kézzel már lehetetlen lett volna feldolgozni.
Ma keresések, vásárlások, mobiltelefonok, szenzorok és internetes szolgáltatások folyamatosan adatokat termelnek. A gépi tanulás és a mesterséges intelligencia ezekből az adatokból próbál mintázatokat felismerni, előrejelzéseket készíteni és döntéseket támogatni.
A sok adat azonban nem feltétlenül jelent jó adatot. Ha az adatok hiányosak, pontatlanok vagy torzak, a mesterséges intelligencia is hibás mintázatokat tanulhat meg.
Az ókori írnok problémája ezért ma is velünk él: nem elég adatokat gyűjteni. Azt is tudnunk kell, honnan származnak, mit mutatnak meg, kik maradtak ki belőlük, és mennyire bízhatunk a belőlük levont következtetésekben.
A statisztika története az ókori gabonajegyzékektől a mesterséges intelligenciáig vezet. Az eszközök rengeteget változtak, de a legfontosabb feladat ugyanaz maradt:
a számok történetet mesélnek – de jól kérdezni, gondosan értelmezni és felelősen dönteni nekünk kell.
Statisztikai fogalmak – mi rejtőzik a számok mögött?
Egy osztály dolgozateredménye, egy sportoló teljesítménye vagy egy üzlet vásárlási adatai rengeteg számot rejtenek. De hogyan lehet ezekből áttekinthető képet alkotni?
A statisztika különböző fogalmai más-más kérdésre válaszolnak. Megmutatják, hol van az adatok közepe, melyik érték fordul elő leggyakrabban, és mennyire különböznek egymástól a megfigyelések.
Ezek a módszerek hosszú fejlődés során alakultak ki. Mögöttük az igazságos elosztás, a pontos mérés és az emberi különbségek megértésének kérdései húzódnak meg.
⚖️ Átlag – amikor mindenkinek ugyanannyi jutna
Képzeljük el, hogy három gyerek 2, 4 és 9 almát gyűjtött. Ha az összes almát egyenlően osztanák szét, mindegyiküknek 5 jutna.
Pontosan ezt fejezi ki a számtani átlag:
Átlag = az adatok összege osztva az adatok számával.
A példában: (2 + 4 + 9) : 3 = 5.
Az átlag minden adatot figyelembe vesz. Ez az előnye, de egyben a gyenge pontja is: egyetlen kiugróan nagy vagy kicsi érték erősen elmozdíthatja. Az átlagos érték ráadásul nem feltétlenül szerepel az eredeti adatok között.
A számtani közép gondolata már az ókori matematikában ismert volt; az angol arithmetic mean elnevezés a 17. század végén is dokumentálható. A fogalom tehát jóval régebbi a modern statisztikánál.
📍 Medián – a sor közepén álló érték
Mi történik, ha nem összeadjuk, hanem nagyság szerint sorba rendezzük az adatokat?
A medián a rendezett adatsor középső értéke. Páratlan számú adatnál a középen álló számot választjuk; páros számú számszerű adatnál a két középső számtani átlagát vesszük.
A 2, 4, 9 adatsor mediánja tehát 4.
Ha a 9 helyére 90 kerül, a medián továbbra is 4 marad, miközben az átlag 32-re emelkedik. Ezért a medián például jövedelmek vagy lakásárak bemutatásakor különösen hasznos: kevésbé érzékeny a szélsőséges értékekre.
A szó a latin medianus, vagyis „középen lévő” kifejezéshez kapcsolódik. Francis Galton a 19. század második felében fontos szerepet játszott statisztikai használatának elterjesztésében. A középső érték gondolata azonban korábbi: a fogalom története és elnevezésének története nem ugyanaz.
👟 Módusz – amiből a legtöbb van
Egy cipőbolt számára nem feltétlenül az átlagos cipőméret a legfontosabb. Sokkal inkább az, melyik méretet keresik a legtöbben.
A módusz az adatsor leggyakrabban előforduló értéke.
A 36, 37, 37, 38, 40 cipőméretek között a módusz 37.
Több, egyformán leggyakoribb érték is lehet. A módusz ráadásul nemcsak számoknál használható: megmutathatja a legnépszerűbb fagylaltízt vagy a legtöbbször választott színt is.
A mode statisztikai elnevezést Karl Pearson vezette be 1895-ben. A név a leginkább szokásos, leggyakoribb érték gondolatát fejezi ki. Pearson ezzel külön nevet adott annak, amit az átlag önmagában nem mond meg: hol sűrűsödnek leginkább az adatok.
🎯 Szórás – mennyire vannak szétszórva az adatok?
Két tanuló három röpdolgozatának pontszámai:
Anna: 5, 5, 5.
Bence: 2, 5, 8.
Mindkettőjük átlaga 5 pont. Anna eredménye azonban teljesen egyenletes, Bencéé változó.
A szórás az adatok átlag körüli szétszóródását méri.
Kiszámításakor az átlagtól vett eltéréseket négyzetre emeljük, majd az így kapott értékekből számolunk tovább, végül négyzetgyököt vonunk. Így a pozitív és negatív eltérések nem oltják ki egymást. A szórás mértékegysége megegyezik az eredeti adatokéval.
Anna szórása nulla, mert minden eredménye azonos. Bencéé nagyobb nullánál.
Az angol standard deviation elnevezést Pearson 1894-es tanulmányában már használta. Maga a matematikai gondolat korábbi mérési és hibaelemzési módszerekből fejlődött ki. Fontos különbség: a szórás nem az eltérések egyszerű átlaga.
↔️ Terjedelem – a két szélső érték távolsága
Mekkora különbség van a legkisebb és a legnagyobb eredmény között?
Erre válaszol a terjedelem:
Terjedelem = legnagyobb adat − legkisebb adat.
Ha egy hét legalacsonyabb napi maximum-hőmérséklete 18 °C, a legmagasabb pedig 27 °C volt, a napi maximumok terjedelme 9 °C.
Ez gyorsan kiszámítható, de csak két adatot használ fel. Nem árulja el, hogyan helyezkednek el közöttük a többi nap értékei.
A szélső értékek összehasonlításának egyszerű gondolata a statisztikában önálló mérőszámmá vált. Az angol range szó ilyen használata a 19. században már dokumentálható.
📊 Kvartilisek – három határpont, négy rész
A medián két részre választja a rendezett adatsort. De mi történik, ha ennél részletesebb képet szeretnénk?
A kvartilisek a rendezett adatok negyedeléséhez tartozó határértékek.
Q₁, az alsó kvartilis: a 25%-os helyzethez tartozó érték.
Q₂, a második kvartilis: a medián, az 50%-os helyzet.
Q₃, a felső kvartilis: a 75%-os helyzethez tartozó érték.
Az alsó és felső kvartilis közötti rész az adatok középső felét jellemzi. A két kvartilis különbsége a kvartilisterjedelem: Q₃ − Q₁. A dobozdiagramon ezt a Q₁ és Q₃ közötti doboz mutatja.
Kis adatsoroknál többféle kvartilisszámítási szabály használatos, ezért különböző tankönyvek vagy programok kissé eltérő eredményt adhatnak.
A név a latin quartus, vagyis „negyedik” szóhoz kapcsolódik. Galton 19. századi munkáiban a kvartilisek már szerepet kaptak az emberek különböző tulajdonságainak összehasonlításában. A sorba rendezés így nemcsak a közép megkeresésére, hanem az adatok elhelyezkedésének feltérképezésére is eszközt adott.
🧭 Hat fogalom, hat kérdés
| Fogalom | Milyen kérdésre válaszol? |
| Átlag | Mennyi jutna egy adatra, ha az összeget egyenlően osztanánk el? |
| Medián | Hol van a rendezett adatsor közepe? |
| Módusz | Melyik érték fordul elő leggyakrabban? |
| Szórás | Mennyire szóródnak az adatok az átlag körül? |
| Terjedelem | Mekkora a legnagyobb és a legkisebb adat különbsége? |
| Kvartilisek | Hol húzódnak a rendezett adatsor negyedelő határai? |
Ugyanaz az adatsor többféle történetet mesélhet. Az egyik szám a közepét mutatja, a másik a leggyakoribb értékét, a harmadik a különbségeket teszi láthatóvá.
A jó statisztikai kérdés ezért mindig megelőzi a számolást: mit szeretnénk megtudni az adatokból?
Diagramok – amikor az adatok láthatóvá válnak
A jó diagram segít összehasonlítani, változásokat követni és mintázatokat felismerni. Mindig azt kérdezzük először: mit szeretnénk megmutatni? Az alábbi ábrák szemléltető, kitalált adatokkal készültek.
Oszlopdiagram – kategóriák összehasonlítása
Az oszlopok magassága az egyes kategóriákhoz tartozó mennyiséget mutatja. Jól használható például szavazatok, eladott termékek vagy létszámok összehasonlítására. A példában az almát 12-en, a szőlőt 3-an választották.
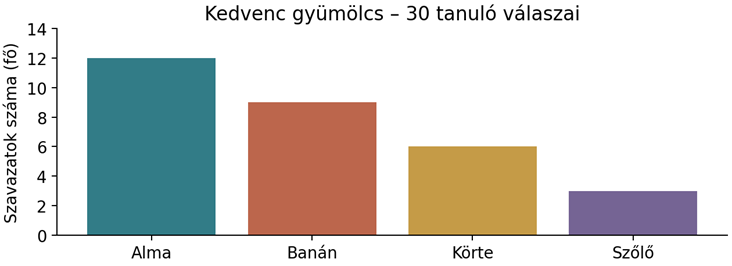
Figyelj rá: az oszlopok legyenek egyforma szélesek, közöttük maradjon rés. A mennyiségi tengely nulláról induljon, hogy az oszlopmagasságok ne torzítsák az arányokat.
Sávdiagram – amikor vízszintesen könnyebb olvasni
A sávdiagram az oszlopdiagram vízszintes változata: a sávok hossza mutatja a mennyiséget. Hosszabb kategórianevek és rangsorok bemutatására különösen alkalmas. A példában a kerékpározás a legnépszerűbb tevékenység.
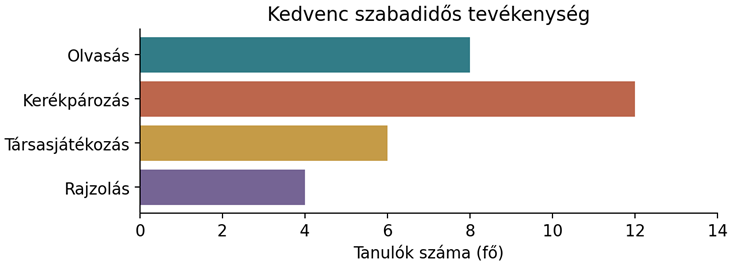
Figyelj rá: itt a vízszintes tengelyen olvassuk le az értékeket. A sávok kezdődjenek közös, nulla értékű alapvonalról.
Vonaldiagram – változás az időben
A pontokhoz tartozó értékeket vonalszakaszok kapcsolják össze. Így könnyen követhetjük például a hőmérséklet, a vízfogyasztás vagy a látogatószám időbeli változását. A példában pénteken volt a legmagasabb déli hőmérséklet.
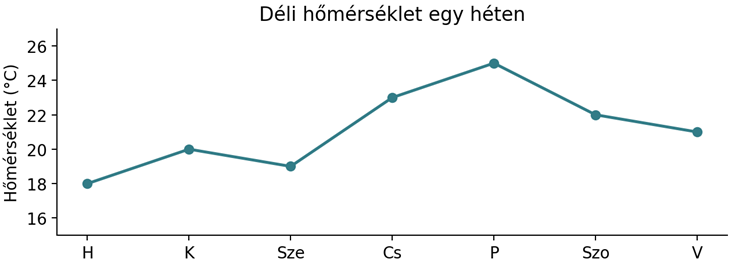
Figyelj rá: az időpontok távolsága feleljen meg az eltelt időnek. Az összekötő vonal nem bizonyítja, hogy a két mérés között pontosan így változott az érték. A tengelynek nem mindig kell nulláról indulnia, de a skála legyen egyértelmű.
Kördiagram – az egész részei
A teljes kör az egész mennyiséget, vagyis 100%-ot jelenti; a körcikkek az egyes részek arányát mutatják. A példában a 30 válasz 40%-a az almára érkezett, ezért az alma körcikke a kör 40%-át foglalja el.
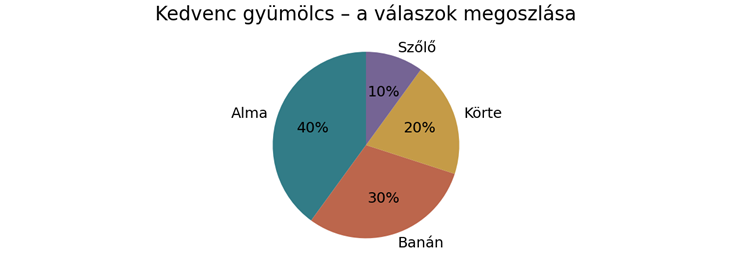
Figyelj rá: a kategóriák együtt adják ki az egészet, és ne fedjék át egymást. Kevés kategóriánál áttekinthető; sok apró szelet összehasonlítására inkább oszlopdiagramot használjunk.
Hisztogram – hogyan oszlanak el a mérési adatok?
A hisztogram számszerű adatokat intervallumokba csoportosít. Az egymáshoz érő téglalapok megmutatják, mely értéktartományban hány megfigyelés található. A példában a 10 perctől 20 percnél rövidebb utazási idők a leggyakoribbak.
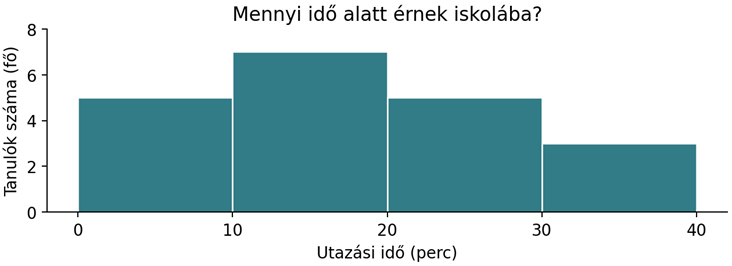
Figyelj rá: ez nem kategóriákat bemutató oszlopdiagram. A példában az intervallumok balról zártak, jobbról nyíltak, az utolsó a 40-et is tartalmazza. Azonos intervallumszélességnél a magasság mutathat gyakoriságot; eltérő szélességnél gyakoriságsűrűséget használunk, így a téglalap területe arányos a gyakorisággal.
Pontdiagram – két mennyiség kapcsolata
Minden pont egy összetartozó adatpárt ábrázol. A példában egy pont egy tanuló gyakorlási idejét és elért pontszámát jelöli. A pontfelhő emelkedő iránya arra utal, hogy a több gyakorlás mellett általában magasabb eredmény jelenik meg.
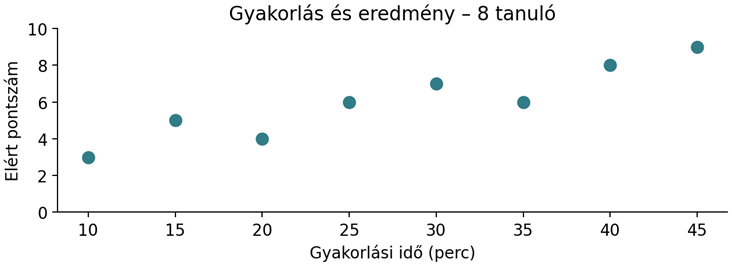
Figyelj rá: az, hogy együtt mozog a két adat, önmagában nem bizonyít ok-okozati kapcsolatot. Más tényezők, például az előzetes tudás is szerepet játszhatnak. A különböző tanulók pontjait nem szükséges összekötni.
Dobozdiagram – sok adat egyetlen dobozban
A dobozdiagram (boxplot vagy sodrófadiagram) röviden összefoglalja, hogyan helyezkednek el az adatok. A doboz egyik széle az alsó kvartilis (Q₁), a másik a felső kvartilis (Q₃), a dobozban húzott vonal pedig a medián. Így a doboz az adatok középső 50%-át mutatja. A példában Q₁ = 14 perc, a medián 20 perc, Q₃ = 26 perc. A legkisebb (minimum) adat a 10 perc, a legnagyobb (maximum) a 35.
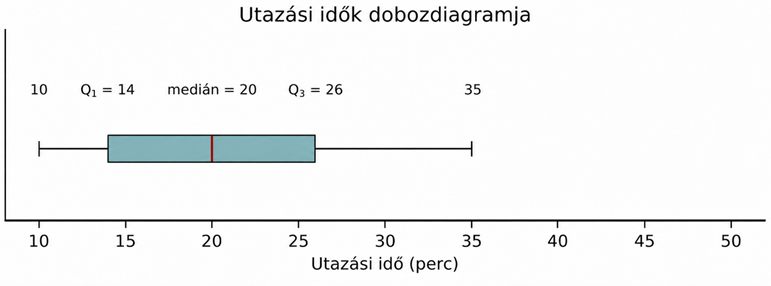
Figyelj rá: A doboz szélei nem a legkisebb (minimum) és a legnagyobb (maximum) adatot jelentik, hanem az alsó kvartilist (Q₁) és a felső kvartilist (Q₃). A dobozban lévő vonal a mediánt mutatja, nem az átlagot. A doboz az adatok középső 50%-át foglalja össze. A dobozon kívül futó vonalak végpontjai ezen az ábrán a minimumot és a maximumot jelölik.
Szár–levél diagram – az eredeti számok is megmaradnak
Ez a különleges ábrázolás egyszerre mutatja meg az adatok eloszlását és az eredeti értékeket. A példában a tízes számjegy a szár, az egyes a levél. Az első sor ezért a 12, 14, 14 és 18 pontos dolgozatokat jelenti. Összesen kilenc eredmény szerepel az ábrán.
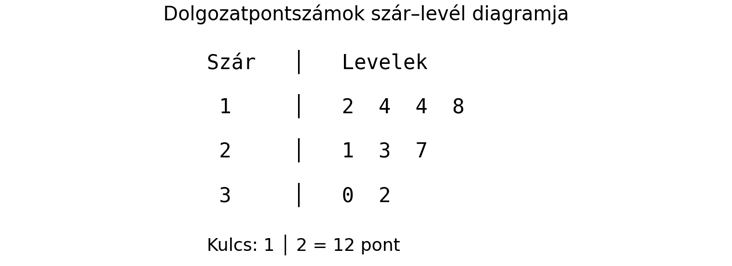
Figyelj rá: a leveleket növekvő sorrendbe rendezzük, az ismétlődő értékeket is feltüntetjük. Mindig szükség van jelölési kulcsra, mert a szár és a levél helyi értéke példánként változhat. Kis adathalmazoknál különösen jól használható.
Magyarok a statisztika történetében
Hányan élünk egy országban? Mit árulnak el az adatok az életkörülményeinkről? Mennyire bízhatunk egy mintából levont következtetésben? A magyar statisztika történetében mindhárom kérdés fontos szerepet kapott. Magyar kutatók az ország megismerését szolgáló adatgyűjtéstől a véletlen matematikai vizsgálatáig sokféleképpen járultak hozzá a tudomány fejlődéséhez.
Fényes Elek – az ország megismerése adatokkal
Fényes Elek (1807–1876) a magyar statisztikai és földrajzi leírás meghatározó alakja volt. Munkáiban Magyarország településeit, népességét és gazdasági viszonyait mutatta be. A Magyarország statistikája című művében az adatokat európai összehasonlításokkal és magyarázatokkal egészítette ki: a számok segítségével az ország helyzetét igyekezett megérteni. [1]
1848-ban ő irányította az első magyar statisztikai intézményt, az Országos Statisztikai Hivatalt. Bár a hivatal a szabadságharc idején csak rövid ideig működhetett, munkája fontos előzménye lett a későbbi rendszeres adatgyűjtésnek. Története azt mutatja, hogy a statisztika már ekkor szorosan kapcsolódott a társadalom megismeréséhez. [1]
Keleti Károly – a hivatalos statisztika megszervezője
Keleti Károly (1833–1892) az 1867-ben létrehozott minisztériumi statisztikai osztály vezetője lett, majd meghatározó szerepet játszott az 1871-ben önállósult statisztikai hivatal megszervezésében. Nevéhez kapcsolódott az 1869-es népszámlálás végrehajtása és a statisztikusok képzését szolgáló tanfolyamok elindítása is. [2]
Munkájának jelentősége abban állt, hogy a megbízható adatgyűjtést rendszeresen működő intézményi feladattá tette. Hiszen egy ország változásairól csak akkor kaphatunk használható képet, ha az adatokat következetesen gyűjtjük, feldolgozzuk és összehasonlíthatóvá tesszük.
Kőrösy József – hogyan hasonlítsunk össze igazságosan?
Kőrösy József (1844–1906), a Fővárosi Statisztikai Hivatal megalapítója a népesség és a halandóság kutatásában alkotott maradandót. Fontos hozzájárulása volt a halálozási arányszámok standardizálásának kidolgozásához és alkalmazásához. Ez az eljárás segít kiszűrni az eltérő korösszetétel hatását az összehasonlításból. [3]
Képzeljünk el két várost: az egyikben sok idős, a másikban sok fiatal ember él. Az elsőben pusztán emiatt is magasabb lehet az összesített halálozási arány. A standardizálás során az életkor szerinti arányokat azonos korösszetételhez viszonyítjuk. Így jobban megítélhető, hogy a különbség mennyiben fakad a korcsoportokon belüli halandóságból.
Rényi Alfréd – a minták és a véletlen matematikája
Rényi Alfréd a valószínűségszámítás mellett a matematikai statisztikában is fontos eredményeket ért el. Vizsgálta a rendezett mintákat és két minta összehasonlításának módszereit. A rendezett minta egyszerűen a megfigyelt értékek növekvő sorrendbe állított sorozata: ebből olvasható ki például a medián vagy valamelyik kvartilis. [4]
1950-től haláláig, 1970-ig vezette a ma nevét viselő matematikai kutatóintézetet. Kutatásaiban gyakorlati kérdések is megjelentek, például a raktárkészletek pótlása és az ipari energiaigény vizsgálata. Munkássága jól érzékelteti a kapcsolatot a véletlen elmélete és az adatokból történő következtetés között. [4–5]
Csörgő Miklós és Révész Pál – magyar iskola a nagy minták elméletében
A Kanadában is jelentős kutatói pályát befutó Csörgő Miklós Révész Pállal együtt kezdeményezője volt az úgynevezett magyar konstrukciós iskolának. Kutatásaik a valószínűségszámítás és a matematikai statisztika határterületéhez, a nagy minták viselkedését leíró közelítésekhez kapcsolódtak. [6]
E terület egyik alapvető kérdése: mi történik a mintából számolt mennyiségekkel, ha egyre több megfigyelésünk van? A megfelelő matematikai közelítések segítenek megérteni a mintavételi ingadozást, és megalapozzák a statisztikai eljárások pontosságának vizsgálatát.
Mit tanulhatunk ebből?
A magyar hozzájárulás az adatgyűjtő intézmények létrehozásában, az összehasonlítás módszereiben és a matematikai alapok fejlesztésében egyaránt megmutatkozik. E történetek közös tanulsága, hogy a jó statisztikához a számolás mellett körültekintés is kell: tudnunk kell, honnan származnak az adatok, mit hasonlítunk össze, és mennyire biztos a következtetésünk.
Források
1. KSH Könyvtár: Fényes Elek életrajza
2. Központi Statisztikai Hivatal: Keleti Károly
3. Statisztikai Szemle, 2006/7.: Kőrösy József-emlékezések
4. Rényi Intézet: Rényi Alfréd cikkei